Biais de récence ou vraie dégradation de service
En décembre 2025, le train de VIA Rail qui devait me ramener de Montréal à Québec en fin de journée s'est immobilisé entre Drummondville et Charny, la batterie de la locomotive ayant cessé de fonctionner. Les passagers sont restés environ quatre heures sur place, sans chauffage et enveloppés dans des couvertures de survie en aluminium. Je suis arrivée chez moi vers 3h30 du matin. Un mois plus tard, je devais retourner à Montréal pour le travail, et mon premier réflexe était de louer une voiture.
Plutôt que de suivre ce réflexe, j'ai appliqué mes propres conseils de consultante IA, c'est-à-dire de partir des données plutôt que de l'impression laissée par l'incident, afin d'éviter le biais de récence. Ce fameux réflexe qui nous fait oublier le passé en faveur des événements récents.
Surprise : l’incident de décembre n’était pas un hasard. Mon historique et les données de VIA Rail montraient la même chose : le train était devenu moins fiable. C’est la même question qu’on se pose avec un modèle d’IA en production : erreur isolée, ou monde qui a changé ?
EN BREF
Question · Un incident marquant suffit-il à conclure qu'un service s'est dégradé, et comment décider de reprendre le train par la suite ?
Approche · Analyse de mes 30 trajets Québec–Montréal (novembre 2023 à décembre 2025), comparaison avec la ponctualité publiée par VIA Rail, puis conception d'un système de prédiction des retards.
Résultat · Les 3 retards graves se concentrent dans les 7 derniers trajets, une configuration improbable si le risque était resté constant (environ 1 %), cohérente avec la baisse de ponctualité publiée par VIA Rail.
Limite · 30 trajets personnels, donc un seul voyageur et un seul itinéraire ; seuls les retards ayant donné lieu à un remboursement complet sont comptés.
Le point de départ : trente trajets et trois retards graves
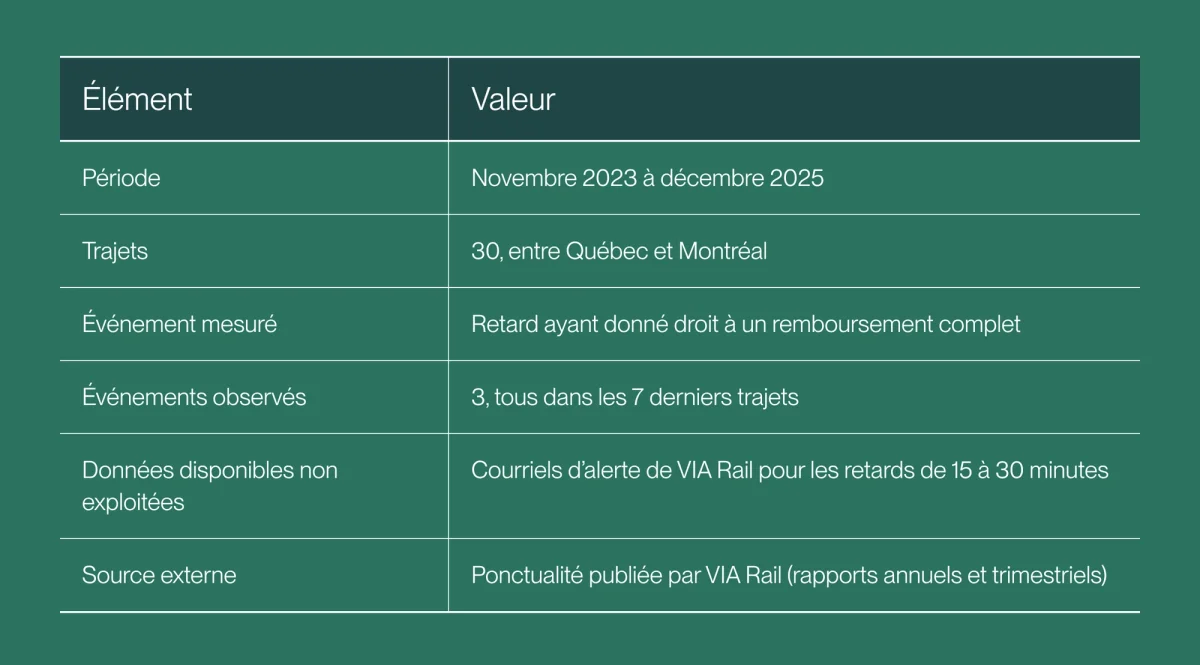
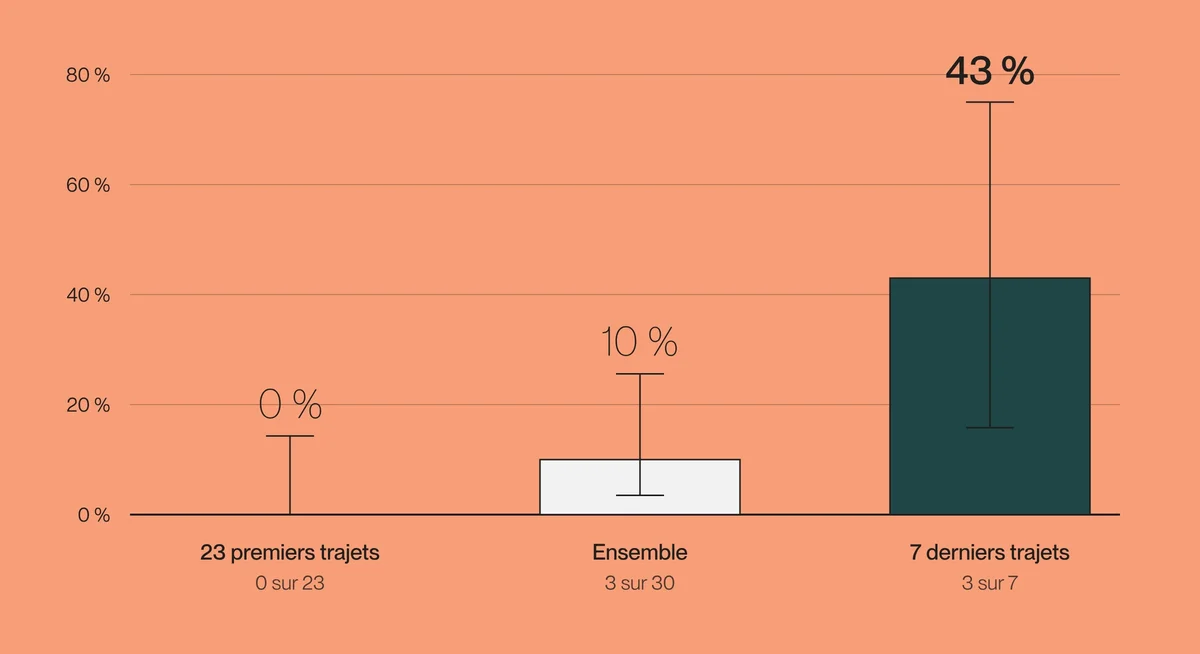
Entre novembre 2023 et décembre 2025, j'ai effectué 30 trajets en train entre Québec et Montréal. Trois d'entre eux ont donné lieu à un remboursement complet en raison d'un retard important, ce qui correspond à un taux global de 10 %. La répartition dans le temps est toutefois très inégale, puisque les 23 premiers trajets se sont déroulés sans retard remboursé alors que les trois remboursements se concentrent dans les 7 derniers.
Tableau 1. Conditions de départ de l'analyse.
Deux lectures de ces chiffres s'opposent, et chacune peut s'appuyer sur une partie des données. La première, dictée par l'expérience récente, retient que près d'un trajet sur deux a mal tourné et conclut qu'il vaut mieux renoncer au train. La seconde, fondée sur l'ensemble de l'historique, rappelle que 27 trajets sur 30 se sont bien passés et qu'un incident spectaculaire ne devrait pas effacer deux ans de résultats corrects. Aucune des deux ne répond toutefois à la question qui compte pour décider, celle de savoir si le risque a réellement changé.
Comprendre la différence entre bruit, biais de récence et changement de régime
En statistique comme en apprentissage automatique, une série d'observations peut varier pour des raisons très différentes.
- Le bruit désigne les fluctuations aléatoires autour d'un niveau stable, de sorte qu'avec un risque constant de 10 %, deux mauvais trajets rapprochés suivis d'une longue période sans incident n'ont rien d'anormal.
- Le biais de récence consiste à accorder un poids excessif aux observations les plus récentes ou les plus marquantes, ce qui conduit souvent à confondre le bruit avec un changement réel. Un incident spectaculaire en est la forme la plus typique.
- Un changement de régime signifie au contraire que le niveau lui-même s'est déplacé, parce qu'une cause nouvelle agit sur le système. Dans un modèle en production, on parle de data drift lorsque les données d'entrée changent de distribution, et de concept drift lorsque la relation entre ces données et le résultat évolue.
CONCEPT · TESTER L'HYPOTHÈSE D'UN RISQUE CONSTANT
Si le risque de retard grave n’avait pas changé, chaque trajet aurait eu la même chance de subir un gros retard. Les trois incidents auraient donc pu tomber n’importe où parmi les 30 trajets. Or, sur les 4 060 façons possibles de les répartir, seulement 35 les placent tous dans les 7 derniers trajets, soit environ 0,9 % de chances que ça arrive par hasard.
Ce calcul comporte toutefois un piège classique, puisque la fenêtre des « 7 derniers trajets » a été choisie après avoir vu les données. La probabilité que trois incidents tombent dans une fenêtre quelconque de 7 trajets consécutifs atteint environ 9 %, ce qui reste faible sans être exceptionnel.
La fenêtre récente n'est pas pour autant arbitraire, puisque c'est précisément la période qui renseigne sur le risque actuel, et la figure 1 montre l'ampleur de l'écart entre les deux périodes. Avec si peu d'observations, les intervalles de confiance restent larges, car le taux des 7 derniers trajets se situe quelque part entre 16 % et 75 % et celui des 23 premiers entre 0 % et 14 %. Ces deux intervalles ne se chevauchent pas, ce qui renforce l'hypothèse d'un changement sans suffire à la démontrer.
Figure 1. Taux de trajets avec retard remboursé par période, avec intervalles de confiance à 95%
Ce que les données publiques de VIA Rail ajoutent au diagnostic
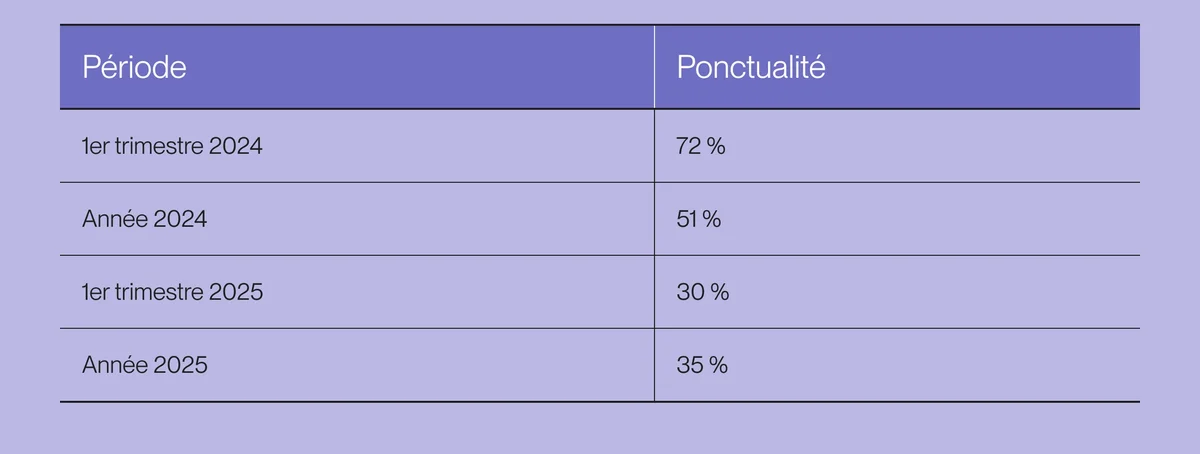
Un petit échantillon devient beaucoup plus parlant lorsqu'on le confronte à une source indépendante. Selon son rapport annuel 2025, VIA Rail affiche une ponctualité de 35 % en 2025, contre 51 % en 2024, et son rapport du premier trimestre 2025 faisait déjà état d'une chute de 72 % à 30 % par rapport au même trimestre de 2024. La société attribue cette baisse aux restrictions imposées par le propriétaire des voies, à des problèmes mécaniques et à la transition vers son nouveau parc de trains.
Tableau 2. Ponctualité publiée par VIA Rail, tous corridors confondus.
Le contexte structurel explique pourquoi VIA Rail maîtrise mal ces facteurs. La société possède moins de 3 % des voies sur lesquelles elle circule, le reste appartenant en majorité au CN, et elle ne bénéficie d'aucun droit de passage prioritaire sur les trains de marchandises, une situation qu'elle demande au gouvernement fédéral de corriger. En octobre 2024, le CN a étendu au corridor Montréal–Windsor une règle qui obligeait déjà les nouveaux trains Venture à ralentir aux passages à niveau entre Montréal et Québec, ce qui ajouterait selon VIA environ 30 minutes par train en moyenne.
Mises côte à côte, les deux sources convergent, puisque la concentration des incidents dans les trajets récents coïncide avec une dégradation documentée du service à l'échelle du réseau. L'historique complet joue ainsi le rôle de niveau de référence, celui par rapport auquel un changement récent devient mesurable, alors qu'un taux global calculé sur toute la période l'aurait masqué. Cette convergence reste toutefois une corrélation. Les données disponibles ne permettent pas d'attribuer les trois incidents observés aux causes que VIA Rail invoque à l'échelle du réseau, d'autant que la panne de décembre relève d'un bris mécanique plutôt que d'une restriction de vitesse.
La décision : estimer le risque et réduire l'impact
Un risque plus élevé ne commande pas automatiquement de renoncer au train, puisqu'une décision dépend à la fois de la probabilité d'un incident et de son coût. Lors de l'incident de décembre, ce coût tenait surtout aux conditions de l'attente, soit le froid, l'absence d'horaire révisé et un retour en pleine nuit.
“J'ai donc repris le train un mois plus tard en agissant sur l'impact plutôt que sur la probabilité.”
Mon sac contenait des vêtements chauds comme pour une journée de ski, de bonnes bottes, des mitaines et des bas de laine, soit l'équivalent de la trousse que l'on garde dans sa voiture l'hiver au Québec et dans les Maritimes. Le train est arrivé à l'heure, ce qui ne dit rien du niveau de risque, une observation favorable isolée ne pesant pas plus lourd qu'un incident isolé.
Passer d'un suivi réactif à une prédiction des retards
L'exercice met en évidence une asymétrie, puisque VIA Rail produit déjà une bonne partie des données nécessaires pour anticiper ses retards sans les exploiter de façon prédictive. Son outil de suivi en temps réel affiche la position et la vitesse du train ainsi que l'heure d'arrivée prévue et réelle à chaque gare, et les passagers reçoivent un courriel à chaque retard, du type « Train 28 a accumulé un retard en raison de la congestion ferroviaire ». Ces informations n'arrivent toutefois qu'une fois le train parti, au moment où il est trop tard pour modifier ses plans.
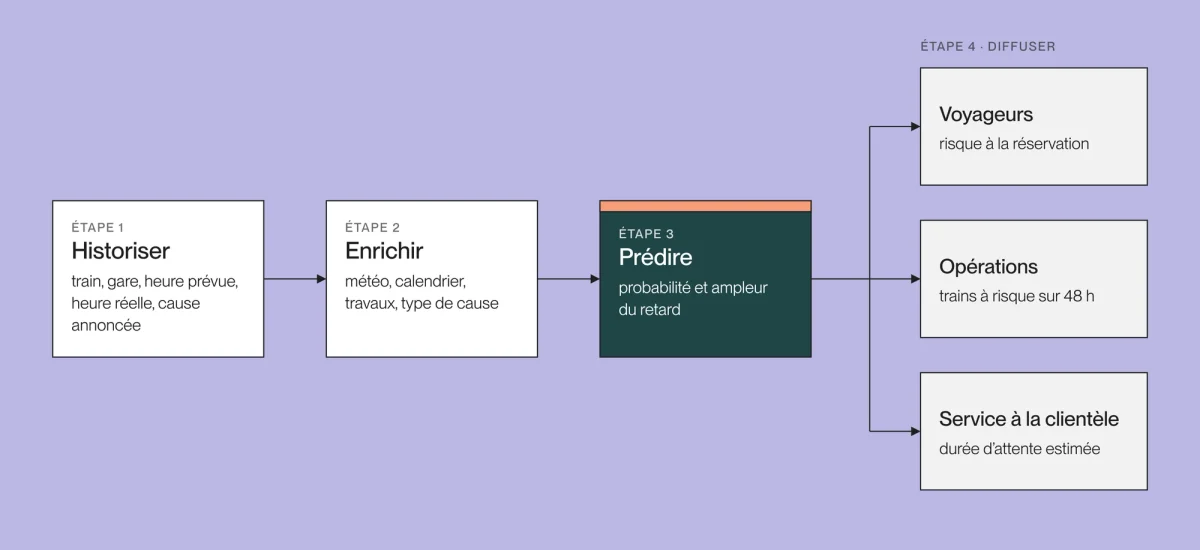
Si VIA Rail nous confiait cette analyse, nous commencerions par conserver ces mises à jour pour en faire un historique, puisqu'un modèle ne peut apprendre que de ce qui a été enregistré. La figure 2 présente le pipeline envisagé, qui comporte quatre étapes.
- Historiser. Chaque mise à jour du suivi devient une observation (numéro de train, gare, heure prévue, heure réelle, cause annoncée), si bien qu'après quelques mois on dispose de l'historique de chaque train et de chaque tronçon.
- Enrichir. Ces observations sont croisées avec la météo (température, neige, verglas), le calendrier (jour, heure de départ, saison), les travaux annoncés et le type de cause, comme la congestion ou le bris mécanique.
- Prédire. Un modèle d'apprentissage automatique supervisé estime, pour un train et une date donnés, la probabilité d'un retard de plus de 30 minutes et son ampleur probable.
- Diffuser. L'estimation est remise aux voyageurs au moment de réserver, aux opérations sous forme de tableau de bord des trains à risque sur 48 heures, et au service à la clientèle pour annoncer une durée d'attente réaliste lorsqu'un train est immobilisé.
Figure 2. Le pipeline proposé pour transformer les données de suivi en temps réel en prédictions de retard.
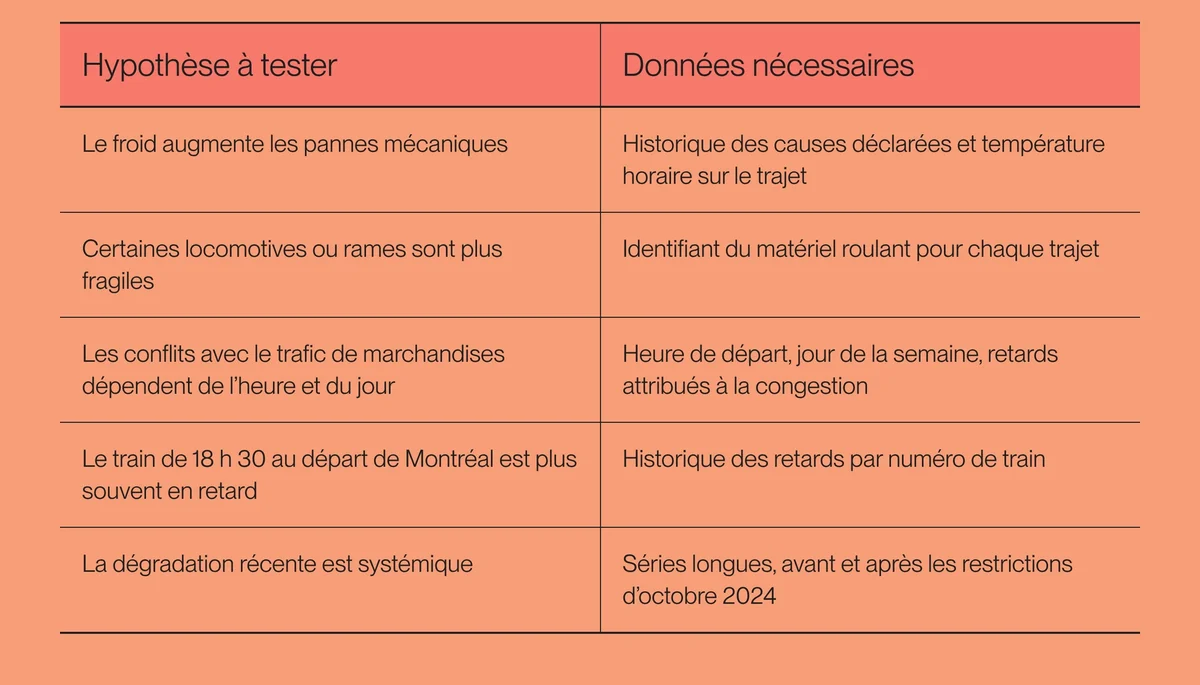
Le modèle de départ n'a pas besoin d'être complexe pour être utile. Un premier modèle simple, par exemple une régression logistique entraînée sur quelques mois d'historique, suffit pour établir un niveau de référence et mesurer ensuite ce qu'apporte chaque nouvelle source de données. Le tableau 3 relie les hypothèses qui circulent sur les retards aux données qui permettraient de les vérifier.
Tableau 3. Hypothèses courantes sur les retards et données nécessaires pour les vérifier.
Limites et conditions de validité
L'analyse personnelle repose sur mes 30 trajets, entre Montréal et Québec, et ne compte que les retards ayant donné lieu à un remboursement complet. Les courriels d'alerte reçus pour les retards de 15 à 30 minutes, ont été conservés mais non utilisés, permettraient de passer d'une mesure d’alerte à une durée estimée du retard. Le calcul de probabilité suppose par ailleurs que les trajets sont indépendants, ce qui n’est pas tout à fait vrai. Les restrictions de vitesse, par exemple, touchent plusieurs trajets consécutifs.
Le système prédictif n’est encore qu’une idée. Pour qu’il soit fiable, il faudrait que les causes inscrites dans les données soient justes : si on note mal pourquoi les problèmes arrivent, le modèle apprendra mal. Et comme le réseau est en train de changer en ce moment, un modèle entraîné maintenant apprendrait une situation qui ne durera pas. Il faudra donc le réentraîner une fois que tout sera stabilisé.
Ce que nous en retenons
- L'historique sert de niveau de référence. Comparer la période récente à celle qui précède rend un changement mesurable, alors qu'un taux global calculé sur toute la période le masque.
- Une fenêtre choisie après coup surestime la surprise. Le même résultat passe d'environ 1 % à environ 9 % de probabilité selon que la fenêtre est fixée avant ou après avoir regardé les données.
- Une source indépendante consolide un petit échantillon. Les données publiques de VIA Rail ont donné au diagnostic un appui que quelques trajets supplémentaires n'auraient pas fourni.
- Une décision combine probabilité et impact. Lorsque la probabilité d'un incident échappe à notre contrôle, réduire son impact reste une option.
Le même raisonnement s'applique lorsqu'un client nous signale qu'un système d'IA « ne marche plus ». Avant de changer de modèle, nous comparons ses performances récentes à celles des six derniers mois, nous vérifions si la baisse est générale ou concentrée sur un segment, et nous cherchons ce qui a changé dans les données ou dans la nature des requêtes. La correction est souvent plus ciblée qu'une refonte, qu'il s'agisse d'une règle d'affaires pour un type de données problématique ou d'un sous-système dédié à un cas limite, pendant que le système principal continue de servir le reste. Ce diagnostic demande d'accepter une part d'incertitude, car un petit nombre d'observations suffit rarement à trancher. La question qui reste ouverte, pour VIA Rail comme pour ces systèmes, est celle du moment où une dégradation cesse d'être une transition et devient le nouveau niveau normal.
Une dégradation à diagnostiquer dans vos données ou vos modèles? Réservez un appel